我们如何用 BrandLens 诊断品牌的 AI 能见度:从打分方法到策略建议

BrandLens 把每条 AI 回答拆成提及、排位、内容占比、推荐程度和情感五项打分,再跨问题看覆盖面和稳定性。品牌据此判断该守、该扩、该提还是该补,并每月复测。
做 GEO 之前,先知道 AI 现在怎么说你
很多品牌开始做 GEO(生成式引擎优化)时,第一个问题都是「我们在 AI 里到底排第几」。只靠市场部同事在手机上问几次 AI、截几张图,很难回答这个问题:AI 每次的回答都会有差别,不同问题差别更大,截图也没法和竞品放在一起比较。
所以我们自己开发了 BrandLens。它读取豆包、DeepSeek、千问和元宝的真实回答,把回答里出现的每个品牌都打一个 0 到 100 的能见度分数,再把多个问题汇总成一张品牌排行。我们所有 GEO 项目的第一步,都是先用它做一次诊断。
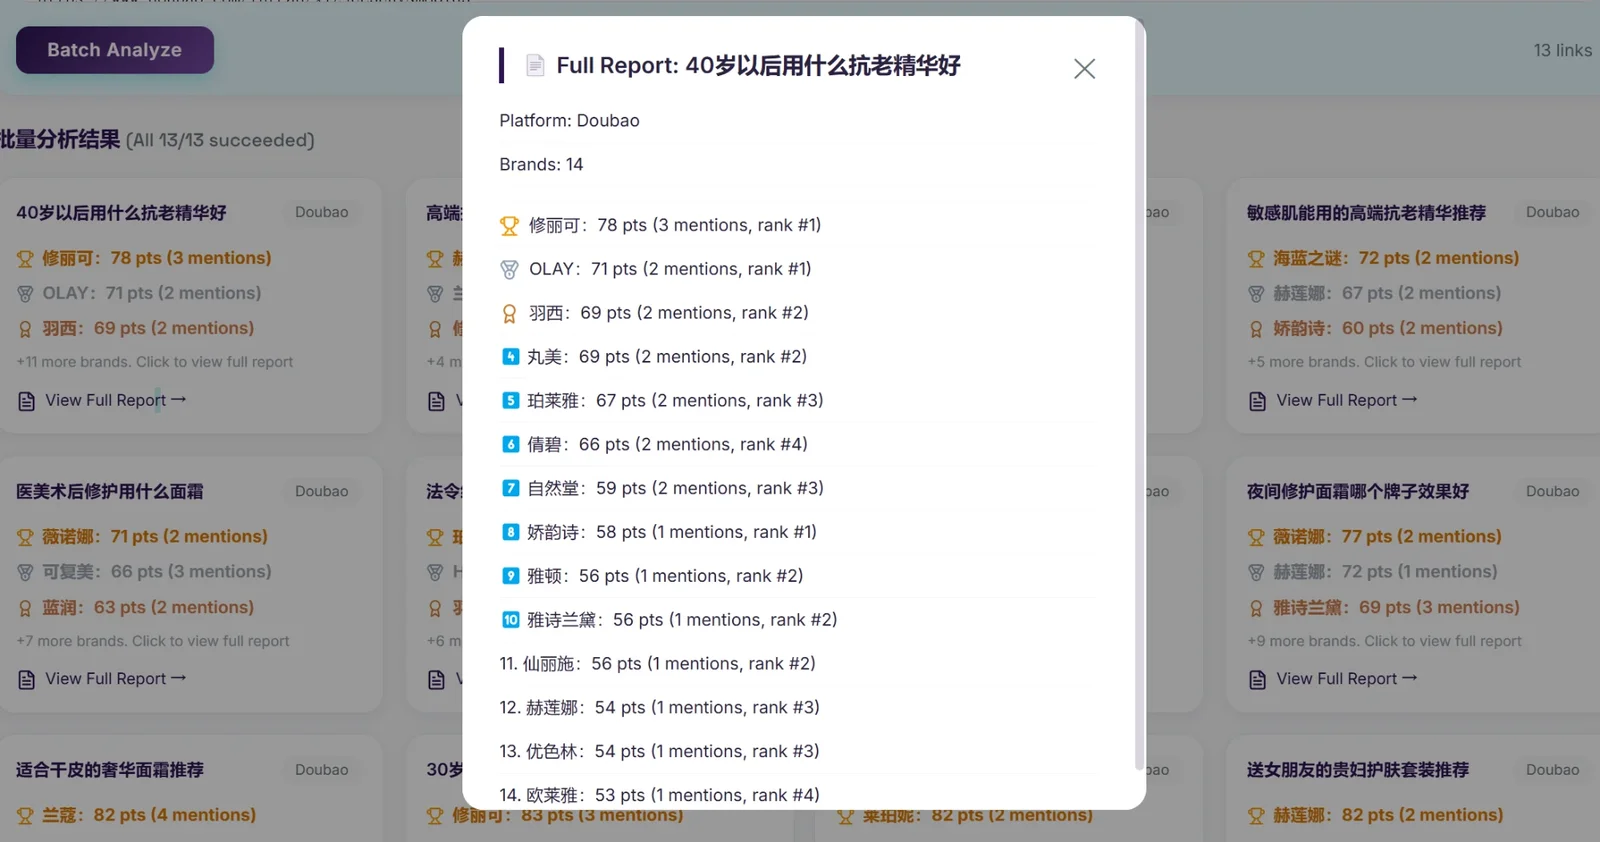
拿高端护肤举个例子。我们在豆包上问了 13 个问题,比如「40 岁以后用什么抗老精华好」「敏感肌能用的高端抗老精华推荐」「医美术后修护用什么面霜」「送女朋友的贵妇护肤套装推荐」,再把这 13 个回答放进 BrandLens 一起看。
第一步:选对问题,比选对平台更重要
诊断的质量取决于问题的质量。我们选问题有三个原则:
- 从客户的真实需求出发:问「敏感肌能用的抗老精华」,而不是问「某某品牌好不好」。客户在 AI 里很少直接搜品牌名,他们描述的是自己的问题。
- 覆盖不同场景:年龄、肤质、医美术后、送礼、夜间修护,每个场景都是一次被推荐或被忽略的机会。
- 参考已有数据:SEM 里转化好的关键词、客服和销售最常被问的问题,都是好问题的来源。
BrandLens 有三种用法:分析单条分享链接,适合快速看一个问题;一次粘贴多条分享链接做批量分析,适合固定的问题清单;还有「品牌雷达」,输入品牌名和官网,工具会自动生成一批问题,在多个 AI 平台上检测品牌有没有被推荐。
第二步:每条回答,按五项给品牌打分
拿到一条 AI 回答后,BrandLens 分五个步骤处理:先识别回答里提到的所有品牌,再统计每个品牌被提到几次、第一次出现在第几位、相关内容占整个回答的比例,最后判断 AI 对它的情感倾向和推荐程度。五项加权合成总分:
| 维度 | 权重 | 衡量什么 |
|---|---|---|
| 首次排位 | 25% | 品牌第一次出现排在第几个,越靠前分越高 |
| 推荐程度 | 25% | 从「极力推荐」到「谨慎选用」分五档 |
| 内容占比 | 20% | 回答里讲这个品牌的篇幅占多少 |
| 提及次数 | 15% | 和本条回答里被提到最多的品牌相比 |
| 情感倾向 | 15% | 从「非常正面」到「非常负面」分五档 |
排位和推荐程度的权重最高,因为对用户的决定影响最大的,是 AI 先说了谁、明确推荐了谁。只是被顺带提一句,分数不会高。我们把 85 分以上视为高能见度,70 到 84 分为较高,55 到 69 分为中等,40 到 54 分为较低。
AI 识别品牌也会出错,比如把成分名、渠道名当成品牌,或者把同一个品牌的中英文名算成两个。BrandLens 支持人工「移除非品牌」和「统一别名」,修正后重新计算,保证排行是干净的。
第三步:跨问题汇总,看覆盖面、质量和稳定性
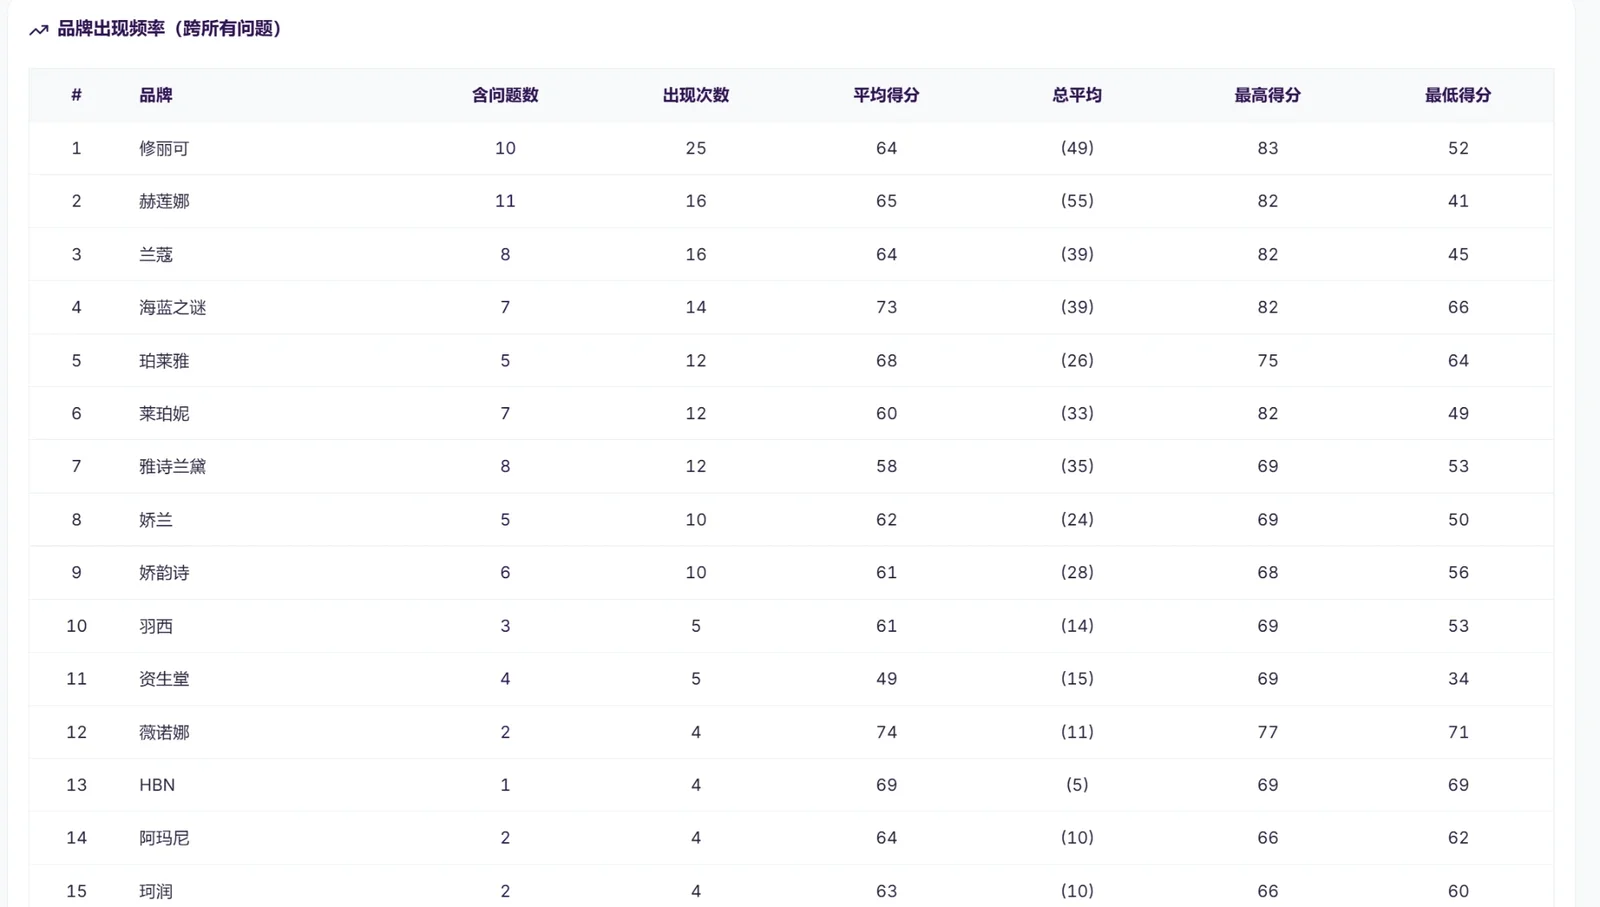
单个问题的结果偶然性很大。在「40 岁以后用什么抗老精华好」这一题里,豆包提到了 14 个品牌,修丽可以 78 分排第一,OLAY、羽西、丸美紧随其后,都在 69 分以上。换一个问题,名单可能完全不同。所以真正有用的是跨问题的汇总:
| 品牌 | 含问题数(共 13) | 出现次数 | 平均得分 | 总平均 | 最高 / 最低 |
|---|---|---|---|---|---|
| 修丽可 | 10 | 25 | 64 | 49 | 83 / 52 |
| 赫莲娜 | 11 | 16 | 65 | 55 | 82 / 41 |
| 兰蔻 | 8 | 16 | 64 | 39 | 82 / 45 |
| 海蓝之谜 | 7 | 14 | 73 | 39 | 82 / 66 |
| 珀莱雅 | 5 | 12 | 68 | 26 | 75 / 64 |
| 莱珀妮 | 7 | 12 | 60 | 33 | 82 / 49 |
| 雅诗兰黛 | 8 | 12 | 58 | 35 | 69 / 53 |
| 资生堂 | 4 | 5 | 49 | 15 | 69 / 34 |
| 薇诺娜 | 2 | 4 | 74 | 11 | 77 / 71 |
这几列分别看什么:
- 含问题数是覆盖面:13 个问题里,品牌在几个回答中出现。
- 平均得分是质量:品牌出现的时候,平均拿到多少分。
- 总平均把没出现的问题记为 0 分,是覆盖面和质量的综合,最接近品牌在这个品类里的「AI 份额」。
- 最高分和最低分的差距是稳定性:差距越大,说明品牌在不同场景里的待遇越不一样。
从这组数据里,我们读出了什么
高端护肤在豆包上还没有「默认答案」。总平均最高的赫莲娜只有 55 分,没有一个品牌既覆盖大部分问题、又稳定拿到 70 分以上。对品牌来说,这意味着位置还没有被占满,现在投入的回报会比品类格局固定之后高。
海蓝之谜的问题是覆盖,不是质量。它只出现在 7 个问题里,但平均 73 分,最低也有 66 分,是表中最稳定的一个。AI 一旦提到它,评价就很高;它缺的是在更多场景里被想起来。
修丽可被提到得最多,但不总是被首推。它在 10 个问题里出现了 25 次,平均每个回答被提到两三次,平均分却是 64 分。下一步要打开单题报告,看它在哪些问题里排位靠后、推荐理由是什么。
赫莲娜覆盖最广,但波动最大。它出现在 11 个问题里,最高 82 分,最低只有 41 分。说明在某些场景里,AI 只是把它列进名单,而没有给出推荐理由。
场景型品牌能「以小博大」。薇诺娜只出现在 2 个问题里,但在「医美术后修护」和「夜间修护面霜」这两个问题中都排第一。珀莱雅出现在 5 个问题里,平均 68 分。在具体的需求场景里,AI 更看重是否对症,而不是品牌的价位。
竞品是 AI 定义的,不是你定义的。在「40 岁以后用什么抗老精华好」里,OLAY、羽西、丸美和高端品牌排在一起。品牌在做竞品分析时,不能只看同价位的对手。
第四步:把诊断变成策略,守、扩、提、补
我们按覆盖面和平均得分两个维度,把品牌放进四种情况,每种情况对应不同的动作:
| 情况 | 策略 | 具体做什么 |
|---|---|---|
| 覆盖广、得分高 | 守 | 每季度更新品牌事实和产品信息,盯住新进入的竞品,防止被替代 |
| 覆盖窄、得分高(如海蓝之谜、薇诺娜) | 扩 | 找出没出现的问题,为这些场景补内容:成分解读、适用人群、使用方法、对比问答 |
| 覆盖广、得分一般(如修丽可、雅诗兰黛) | 提 | 看 AI 给的推荐理由和情感判断,补充有说服力的证据,例如临床数据、权威评测、真实用户反馈 |
| 覆盖窄、得分低(如资生堂) | 补 | 先检查 AI 说的是否准确,再补齐官网、百科和权威媒体上的基础信息 |
如果客户品牌在报告里完全没有出现,BrandLens 会标注为「客户品牌(未曝光)」。这时第一步不是急着发内容,而是看清楚:这些问题被哪些竞品占住了,AI 引用的是哪些网站。分平台看信源很重要,因为不同 AI 引用的网站差别很大。
这里的「守、扩、提、补」是基于一次公开测试的方法示范,不是对这些品牌的评价。真实项目里,我们会结合品牌自己的产品、目标人群和渠道来选问题和定优先级。
第五步:每月复测,把能见度和生意联系起来
AI 的回答会变:模型更新、新内容被收录、竞品发力,都会改变排名。一次诊断只是起点。我们的做法是:
- 固定问题清单,每月复测:用同一批问题在同一组平台上重新测,看总平均、含问题数和最低分的变化,批量结果可以导出 Excel 存档对比。
- 每个问题不只测一次:AI 回答有随机性,重要的问题要多测几次,看趋势而不是看单次结果。
- 和生意数据一起看:能见度提升之后,观察询盘里「AI 推荐」来源的占比、品牌词搜索量和官网直访流量有没有跟着变化。我们在品牌做 GEO 的五个判断里详细讲过这些指标。
想知道你的品牌在豆包、DeepSeek、千问和元宝里是什么位置?可以了解我们的 GEO 生成式引擎优化服务,或者直接联系我们,我们可以先帮你做一次 BrandLens 诊断。
BrandLens 看的是某一个时间点的情况。信源和推荐名单每个月会怎么变,可以看我们的数据报告:AI 的信源每月都在换。
诊断之后怎样按月追踪效果,见怎么衡量 GEO 优化的效果:4 个指标和一份月度看板。
延伸阅读:AI 能见度监测工具怎么选。
关键数据与来源
| 数据 | 数值 | 来源 |
|---|---|---|
| 豆包高端护肤问题测试 | 共 13 个问题;「40 岁以后用什么抗老精华好」一题提到 14 个品牌 | Dékuple China BrandLens 测试,2026 年 11 月 |
| 跨 13 个问题的品牌出现频率 | 赫莲娜出现在 11 个问题中,总平均 55 分;海蓝之谜平均 73 分,最低 66 分;修丽可出现 25 次 | Dékuple China BrandLens 测试,2026 年 11 月 |
| BrandLens 能见度评分权重 | 首次排位 25%、推荐程度 25%、内容占比 20%、提及次数 15%、情感倾向 15% | Dékuple China BrandLens 方法说明 |
常见问题
BrandLens 支持哪些 AI 平台?
目前支持豆包、DeepSeek、千问和元宝。可以分析单条分享链接,也可以一次批量分析多条链接,或者用品牌雷达自动生成问题,在多个平台上检测。
BrandLens 的能见度分数是怎么算的?
每条回答里的每个品牌按五项打分再加权:首次排位 25%、推荐程度 25%、内容占比 20%、提及次数 15%、情感倾向 15%,满分 100 分。跨问题汇总时,再看含问题数、平均得分、总平均和最高最低分。
「平均得分」和「总平均」有什么区别?
平均得分只算品牌出现过的问题,反映出现时的质量;总平均把没出现的问题记为 0 分,同时反映覆盖面和质量,更接近品牌在品类里的 AI 份额。
做一次诊断需要多少个问题?
建议从 10 到 30 个贴近客户真实需求的问题开始,覆盖不同场景和人群。问题太少,结果容易受单次回答的随机性影响。